El informe de un DataFrame
La primera mirada a unos datos antes de escribir un ETL o de cargar una tabla: qué hay y qué tiene de raro, en un HTML que se abre en el navegador, se comparte y se archiva junto a los datos. No es una herramienta de BI ni un notebook: es la primera mirada.
from tai_storage.data import read
from tai_storage.analysis import analyze

ventas = read(folder.get_file("ventas.csv"))
clientes = read(folder.get_file("clientes.csv"))

report = analyze(
    ventas,
    title="Ventas 2024",
    key="id_venta",                                        # debería identificar cada fila
    references={"id_cliente": (clientes, "id", "clientes")},  # integridad referencial
)
report.save("ventas.html")                                 # ruta local
report.save(folder.get_file("informes/ventas.html"))       # o un File de cualquier origen
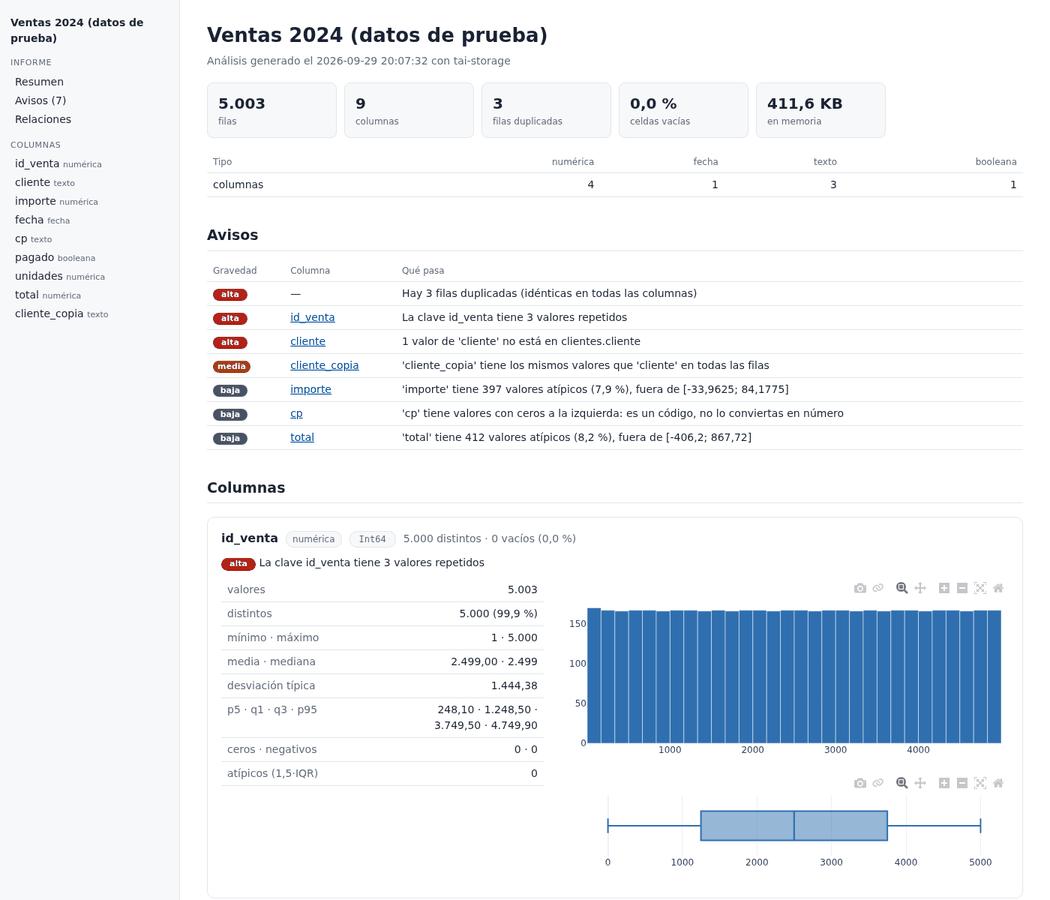
Qué lleva
- Resumen: filas, columnas, filas duplicadas, % de celdas vacías, memoria y columnas por tipo.
- Avisos, de más a menos grave y enlazados a su columna.
- Una ficha por columna, según su tipo:
- numérica: mínimo, máximo, media, mediana, desviación, cuantiles, ceros, negativos y atípicos, con histograma y caja;
- fecha: rango, histograma temporal (por día, semana, mes o año según el rango) y huecos;
- texto: longitudes, vacíos, solo cifras, ceros a la izquierda y espacios en los extremos;
- booleana: verdaderos y falsos;
- todas: nulos, distintos y los valores más frecuentes.
- Relaciones: correlación de Pearson entre numéricas, coincidencia entre columnas (para ver las duplicadas; hasta 60 columnas), qué columnas determina la clave y la integridad con otras tablas.
Avisos
| Código | Gravedad | Cuándo |
|---|---|---|
duplicadas |
alta | filas idénticas en todas las columnas |
vacia |
alta | una columna sin ningún valor |
clave_duplicada, clave_nula |
alta | la key= se repite o está vacía |
integridad |
alta | valores que no están en la tabla de references= |
constante |
media | siempre el mismo valor |
nulos |
media | más del nulls_pct (50 %) de vacíos |
parece_numero, parece_fecha |
media | texto cuyo looks_like (90 %) son números o fechas |
columnas_iguales |
media | dos columnas con el mismo valor en todas las filas |
clave |
baja | sin key=: texto o entero distinto en cada fila, con key_min_rows (20) o más filas |
ceros |
baja | ceros a la izquierda: es un código, no un número |
espacios |
baja | espacios al principio o al final |
atipicos |
baja | más del outliers_pct (1 %) fuera de 1,5 × IQR |
columnas |
baja | más de max_columns (200): el resto sale solo en el resumen |
Los umbrales se cambian en analyze(df, thresholds={"nulls_pct": 20}); un nombre que no existe es
un InvalidRequestError. Un texto con ceros a la izquierda o de más de 15 cifras no avisa de que
parece un número: convertirlo perdería los ceros o los últimos dígitos.
Lo que no hace
- No infiere tipos: el tipo de cada columna es su
dtype. Si el DataFrame viene detai_storage.dataya está bien tipado; un texto que parece número sale como aviso. - No lee ficheros: recibe un DataFrame. Solo
save()escribe. - No mete las filas en el HTML: a Plotly le llegan los contenedores del histograma, los
cuartiles y los recuentos, así que el tamaño depende de las columnas y no de las filas. Un
millón de filas por 50 columnas se analiza en unos 15 s y da un HTML de unos 5 MB, casi todo
Plotly;
plotly_js="cdn"lo deja en lo que ocupan los datos (necesita red al abrirlo).